















大規模言語モデルを自分のハードウェアで動かせば、プロンプトとデータを自分の管理下に置け、トークン単位の料金もかかりません。このガイドでは、必要な GPU メモリの量と、レンタルした GPU サーバーでモデルを動かす方法を説明します。
重要な数値: VRAM
モデルはグラフィックカードのメモリ(VRAM)に収まる必要があります。おおよその目安は、パラメータ数(十億単位)に1重みあたりのバイト数を掛け、コンテキストキャッシュ用に20〜30パーセントを加えた値です。
| モデルサイズ | 4ビット量子化 | 16ビット(フル) | 収まる GPU |
|---|---|---|---|
| 7〜8B | 約 5 GB | 約 16 GB | RTX 4090 (24 GB) |
| 13〜14B | 約 9 GB | 約 28 GB | RTX 4090(量子化時)、RTX 5090 (32 GB) |
| 30〜34B | 約 20 GB | 約 68 GB | RTX 4090 または 5090(量子化時)、H100 |
| 70B | 約 40 GB | 約 140 GB | H100 80 GB(量子化時)、16ビットなら H100 2枚 |
量子化は重みをより少ないビット数で保存する手法で、品質の低下をわずかに抑えつつ、メモリを大幅に削減します。多くの人が大きなモデルをコンシューマー向けカードで動かせるのは、このおかげです。
方法 1: Ollama(最も簡単)
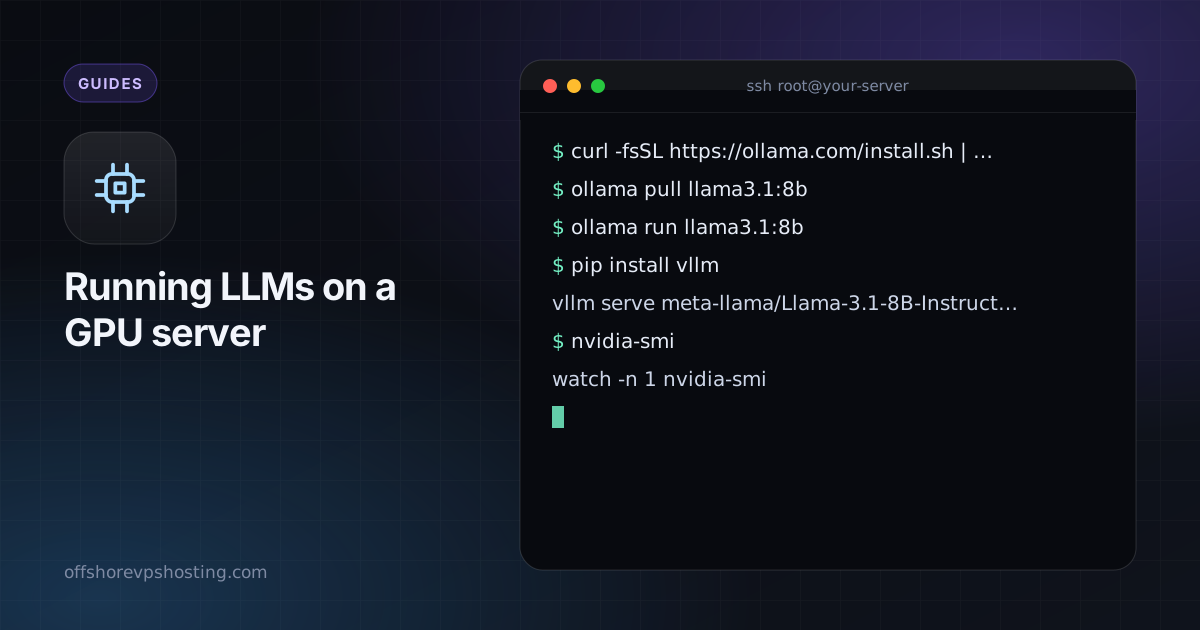
curl -fsSL https://ollama.com/install.sh | sh
ollama pull llama3.1:8b
ollama run llama3.1:8b
Ollama は、ダウンロード、量子化、ポート 11434 のローカル API を処理します。このポートは非公開にするか、前段に認証を置いてください。
方法 2: vLLM(最高のスループット)
pip install vllm
vllm serve meta-llama/Llama-3.1-8B-Instruct --max-model-len 8192
vLLM は OpenAI 互換の API を提供し、多数のリクエストをまとめて処理します。複数のユーザーやアプリケーションが1つの GPU を共有する場合に適しています。モデルによっては、先にモデルのページでライセンスに同意する必要があります。
GPU が使われていることを確認する
nvidia-smi
watch -n 1 nvidia-smi
モデルの読み込み時にメモリ使用量が急増し、生成中に使用率が上がるはずです。どちらもゼロのままなら、モデルは CPU で動いています。
レンタル GPU で他によく動かされるもの
- 画像生成(Stable Diffusion、ComfyUI)。
- LoRA による小型モデルのファインチューニング。
- 動画や 3D のレンダリング、動画のトランスコード。
- Whisper による音声文字起こし。
コストの考え方
GPU が週に数時間しか必要ないなら、月額でのレンタルは API より高くつくこともあります。一日中推論を動かす場合やプライバシーが必要な場合は、専用 GPU サーバーのほうが有利なのが普通です。決める前に、月間のトークン数を見積もってください。