















Büyük bir dil modelini kendi donanımınızda çalıştırmak, istemlerinizi ve verilerinizi kendi kontrolünüzde tutar ve token başına ücretlerden kurtarır. Bu rehber ne kadar GPU belleğine ihtiyacınız olduğunu ve bir modeli kiralık bir GPU sunucusunda nasıl çalıştıracağınızı açıklar.
Önemli olan sayı: VRAM
Bir modelin ekran kartının belleğine (VRAM) sığması gerekir. Kaba bir kural: milyar cinsinden parametre sayısı çarpı ağırlık başına bayt, artı bağlam önbelleği için yüzde 20 ila 30.
| Model boyutu | 4 bit nicemlenmiş | 16 bit tam | Sığdığı GPU |
|---|---|---|---|
| 7 ila 8B | yaklaşık 5 GB | yaklaşık 16 GB | RTX 4090 (24 GB) |
| 13 ila 14B | yaklaşık 9 GB | yaklaşık 28 GB | RTX 4090 nicemlenmiş, RTX 5090 (32 GB) |
| 30 ila 34B | yaklaşık 20 GB | yaklaşık 68 GB | RTX 4090 veya 5090 nicemlenmiş, H100 |
| 70B | yaklaşık 40 GB | yaklaşık 140 GB | H100 80 GB nicemlenmiş; 16 bit için 2× H100 |
Nicemleme, ağırlıkları daha az bitle saklar; bu, kalitede küçük bir kayıpla belleği keskin biçimde azaltır. Çoğu kişi büyük modelleri tüketici kartlarında bu sayede çalıştırır.
Seçenek 1: Ollama (en basit)
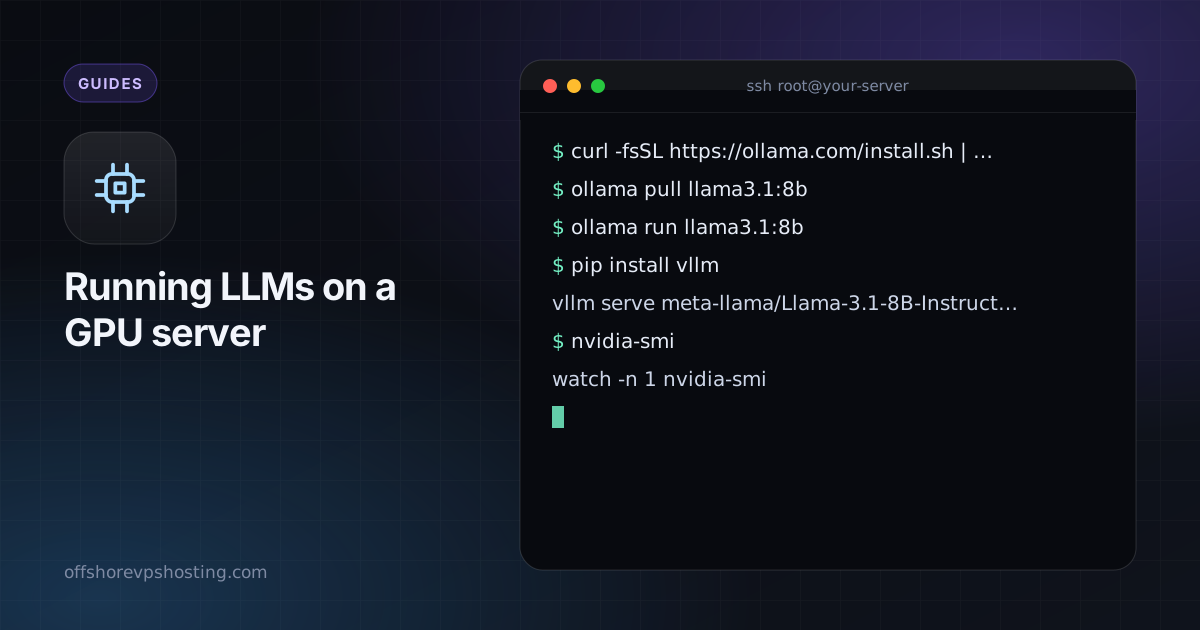
curl -fsSL https://ollama.com/install.sh | sh
ollama pull llama3.1:8b
ollama run llama3.1:8b
Ollama; indirmeleri, nicemlemeyi ve 11434 portunda yerel bir API'yi halleder. Bu portu özel tutun veya önüne kimlik doğrulama koyun.
Seçenek 2: vLLM (en iyi verim)
pip install vllm
vllm serve meta-llama/Llama-3.1-8B-Instruct --max-model-len 8192
vLLM, OpenAI uyumlu bir API sunar ve birçok isteği toplu işler; bu da birkaç kullanıcı veya uygulama tek bir GPU'yu paylaştığında onu daha iyi bir seçim yapar. Bazı modeller, önce modelin sayfasında bir lisansı kabul etmenizi gerektirir.
GPU'nun kullanıldığını kontrol edin
nvidia-smi
watch -n 1 nvidia-smi
Model yüklendiğinde bellek kullanımı sıçramalı, üretim sırasında ise kullanım oranı yükselmelidir. İkisi de sıfırda kalıyorsa model CPU üzerinde çalışıyordur.
İnsanların kiralık GPU'larda çalıştırdığı diğer işler
- Görüntü üretimi (Stable Diffusion, ComfyUI).
- LoRA ile küçük modellerin ince ayarı.
- Video ve 3B render ile video kodlama dönüştürme.
- Whisper ile konuşmadan metne dönüştürme.
Maliyet hesabı
Haftada birkaç saat GPU'ya ihtiyacınız varsa aylık kiralamak yine de bir API'den pahalıya gelebilir. Gün boyu çıkarım yapıyorsanız veya gizliliğe ihtiyacınız varsa, ayrılmış bir GPU sunucusu genellikle kazanır. Karar vermeden önce aylık token sayınızı hesaplayın.