















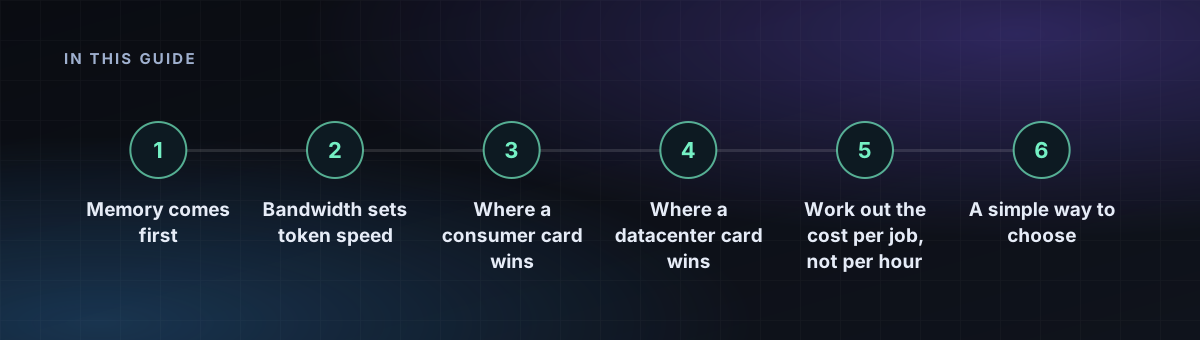
Untuk AI yang di-host sendiri, pertanyaannya jarang "kartu mana yang tercepat". Pertanyaannya adalah "kartu mana yang muat untuk model yang ingin saya jalankan, dengan biaya per jam yang bisa saya pertanggungjawabkan". Memori menentukan apa yang muat, bandwidth menentukan seberapa cepat token keluar, dan harga menentukan apakah proyek ini masuk akal sama sekali.
Memori yang utama
Jika model tidak muat di memori video, kecepatan tidak relevan. Aturan kasar: model membutuhkan sekitar jumlah parameter dikali byte per bobot, ditambah ruang untuk cache konteks.
- Model 7B hingga 8B dalam 4-bit membutuhkan sekitar 5 sampai 6 GB.
- Model 13B hingga 14B dalam 4-bit membutuhkan sekitar 9 sampai 10 GB.
- Model 32B dalam 4-bit membutuhkan sekitar 20 sampai 22 GB, yang muat di kartu 24 GB dengan konteks pendek.
- Model 70B dalam 4-bit membutuhkan sekitar 40 GB atau lebih, jadi perlu kartu 48 GB atau 80 GB atau beberapa kartu yang lebih kecil.
Konteks panjang membuat cache membesar dengan cepat, jadi sisakan ruang cadangan.
Bandwidth menentukan kecepatan token
Untuk satu pengguna, menghasilkan setiap token berarti membaca bobot model satu kali. Itu menjadikan bandwidth memori sebagai batasnya. Kartu datacenter dengan memori HBM memiliki bandwidth beberapa kali lipat dari kartu GDDR konsumen, itulah sebabnya H100 menghasilkan token lebih cepat pada model yang sama.
Di mana kartu konsumen unggul
- Model hingga sekitar 30B dalam 4-bit.
- Pembuatan gambar seperti Stable Diffusion dan Flux.
- Pengembangan, pengujian, dan penggunaan pribadi bervolume rendah.
- Biaya: harga per jam hanya sebagian kecil dari kartu datacenter.
Di mana kartu datacenter unggul
- Model kelas 70B tanpa kompresi berat.
- Banyak pengguna sekaligus, di mana batching memanfaatkan komputasi ekstra dengan baik.
- Tautan cepat antar beberapa GPU untuk model yang lebih besar.
- Beban kerja dengan konteks panjang dan presisi tinggi.
Hitung biaya per pekerjaan, bukan per jam
Ukur token per detik Anda sendiri dengan model yang benar-benar akan dijalankan. Lalu bagi harga per jam dengan jumlah token per jam. Kartu murah yang lambat bisa lebih mahal per sejuta token daripada kartu mahal yang cepat, dan sebaliknya jika kartu murah tidak terus dipakai. Waktu menganggur adalah biaya tersembunyi, jadi matikan server saat tidak dipakai.
Cara sederhana untuk memilih
- Pilih model dan kuantisasi yang Anda inginkan.
- Pastikan model itu muat dengan sisa ruang untuk konteks.
- Sewa kartu termurah yang muat dan lakukan benchmark selama satu jam.
- Naik ke kartu yang lebih besar hanya jika kecepatan atau konkurensi tidak memenuhi target Anda.
Siap mencoba? Jalankan Ollama dan Open WebUI atau siapkan Stable Diffusion. Harga dan kartu berubah, jadi pastikan pilihan terbaru di halaman server GPU.