















Ejecutar la generación de imágenes en tu propio servidor GPU significa que ningún tercero guarda registros de tus prompts, que no hay filtros de contenido que no hayas elegido y que el coste se mantiene fijo sin importar cuántas imágenes hagas. Esta guía configura ComfyUI, una interfaz basada en nodos para Stable Diffusion y modelos similares, en Ubuntu.
Elige la GPU
La memoria de vídeo es el factor limitante. 8 GB ejecutan SD 1.5 con comodidad, de 12 a 16 GB manejan bien SDXL y 24 GB dan margen para modelos nuevos más grandes y resoluciones mayores. Si no estás seguro, consulta GPU de consumo frente a GPU de centro de datos. Deja también unos 50 GB de disco, porque los archivos de modelo son grandes.
Paso 1: comprueba el controlador
nvidia-smiSi muestra tu GPU, el controlador funciona. Si no, instala el controlador recomendado con sudo ubuntu-drivers autoinstall y reinicia.
Paso 2: instala ComfyUI
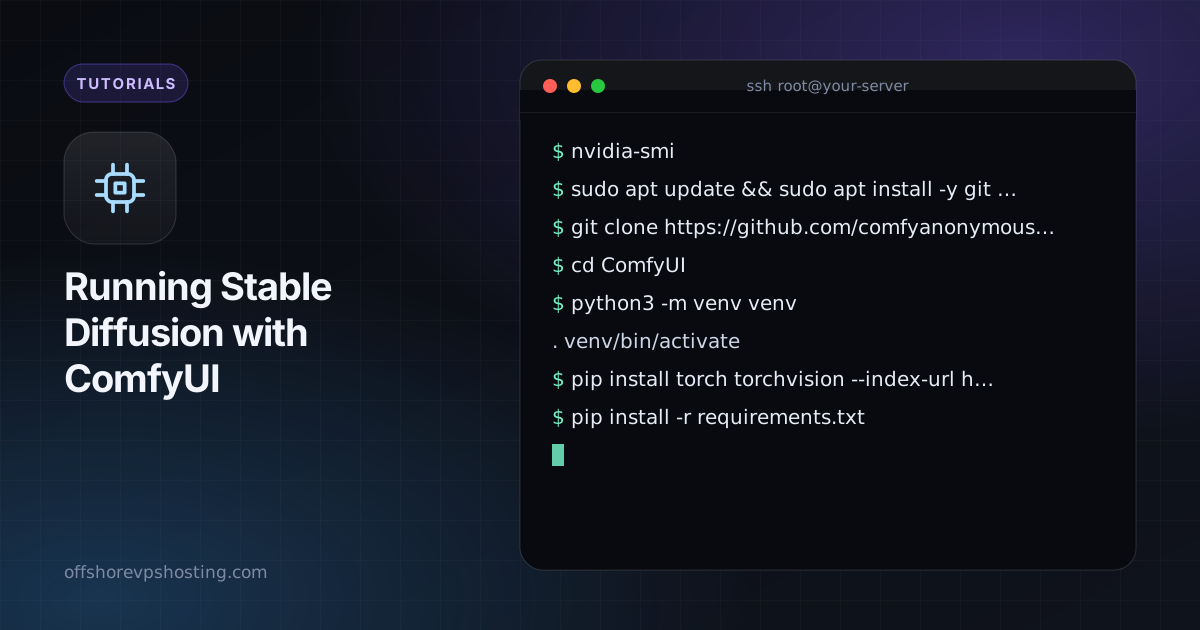
sudo apt update && sudo apt install -y git python3-venv
git clone https://github.com/comfyanonymous/ComfyUI
cd ComfyUI
python3 -m venv venv
. venv/bin/activate
pip install torch torchvision --index-url https://download.pytorch.org/whl/cu121
pip install -r requirements.txt
Ajusta el índice de wheels de CUDA a la versión que PyTorch recomienda para tu controlador. Consulta su página de instalación si el comando de arriba ha cambiado.
Paso 3: añade un modelo
Descarga un checkpoint que tengas licencia para usar en ComfyUI/models/checkpoints/. Lee la licencia del modelo sobre uso comercial antes de construir un producto con él.
cd models/checkpoints
wget -O model.safetensors "https://example.com/path/to/model.safetensors"
Paso 4: inícialo en privado
Por defecto ComfyUI escucha solo en localhost, que es lo que quieres. Accede a él mediante un túnel SSH.
python main.py --listen 127.0.0.1 --port 8188ssh -L 8188:127.0.0.1:8188 user@your-serverAbre http://127.0.0.1:8188 en tu propio ordenador. No expongas el puerto a internet: por defecto no tiene inicio de sesión.
Paso 5: mantenlo en ejecución
sudo tee /etc/systemd/system/comfyui.service > /dev/null <<'UNIT'
[Unit]
Description=ComfyUI
After=network-online.target

[Service]
User=ubuntu
WorkingDirectory=/home/ubuntu/ComfyUI
ExecStart=/home/ubuntu/ComfyUI/venv/bin/python main.py --listen 127.0.0.1
Restart=on-failure

[Install]
WantedBy=multi-user.target
UNIT
sudo systemctl daemon-reload && sudo systemctl enable --now comfyui
Ajusta el usuario y las rutas a tu servidor.
Coste y privacidad frente a herramientas alojadas
- Coste: una GPU por horas cuesta lo mismo si haces diez imágenes o diez mil. Sale mejor que el precio por imagen cuando generas en bloque y peor cuando generas poco, así que detén el servidor cuando esté inactivo.
- Privacidad: los prompts y los resultados se quedan en una máquina que controlas, y puedes pagar con Monero u otras monedas sin identificación.
- Control: tú eliges el modelo, el sampler y los ajustes de seguridad, y asumes la responsabilidad de cómo los uses.
Para modelos de texto en el mismo hardware, consulta Ollama y Open WebUI.